Распознавание текста с фотографии для работы и повседневных задач
Фотография документа, снимок страницы книги или изображение с важными сведениями часто содержат информацию, которую необходимо перенести в электронный формат. Ручной набор занимает время, особенно если речь идет о нескольких страницах, длинных перечнях или документах с большим количеством цифр. Технология оптического распознавания символов позволяет извлекать текст непосредственно из изображения, сохраняя возможность редактирования, копирования и дальнейшей обработки.
Сервис распознать текст с фото онлайн помогает сократить путь от изображения к готовому тексту. Вместо последовательного перепечатывания пользователь получает возможность обработать фотографию в цифровом инструменте и использовать извлеченные сведения для подготовки документов, учебных материалов, отчетов или публикаций. Практическая ценность такого решения заключается не только в экономии времени, но и в упрощении работы с информацией, которая изначально существует лишь в графическом виде.
Почему изображения стали важным источником информации
Значительная часть полезных сведений хранится в форме, неудобной для прямого редактирования. Даже при наличии смартфона и облачных хранилищ текст на фотографии остается изображением: его нельзя полноценно исправить, быстро найти по слову или перенести в другой документ без дополнительной обработки.
Такая ситуация встречается в самых разных сферах. Специалист фотографирует записи с совещания, студент сохраняет страницу учебника, предприниматель получает снимок накладной, а редактору требуется извлечь цитату из печатного материала. Во всех этих случаях исходная информация уже доступна, но для дальнейшей работы ее необходимо преобразовать в текст.
Ручной перенос остается возможным решением, однако его эффективность снижается с увеличением объема. При перепечатывании приходится одновременно следить за содержанием, сохранять последовательность строк и проверять правильность цифр. Ошибки особенно вероятны при работе с длинными документами, таблицами и мелким шрифтом.
Автоматизированное распознавание снимает значительную часть этой нагрузки. Оно превращает изображение в материал, с которым можно работать привычными средствами: текстовыми редакторами, электронными таблицами, системами поиска и программами для подготовки отчетности.
Что представляет собой технология OCR
OCR — Optical Character Recognition, или оптическое распознавание символов. Это технология, которая анализирует изображение и определяет, какие буквы, цифры и другие знаки на нем представлены.
Обычный графический файл хранит сведения о цвете и расположении пикселей. Для компьютера слово на фотографии первоначально выглядит как совокупность визуальных элементов, а не как последовательность букв. Система OCR анализирует их форму, расположение и контекст, после чего формирует текстовую последовательность.
В зависимости от инструмента результатом может стать обычный текст, который удобно копировать и редактировать, либо документ с частично сохраненным расположением исходных элементов.
Распознавание обычно включает несколько этапов:
- Подготовка изображения. Система определяет границы документа, оценивает качество снимка и при необходимости корректирует его положение.
- Анализ символов. Алгоритмы выделяют текстовые области, строки и отдельные элементы.
- Определение букв и цифр. Программа сопоставляет визуальные признаки с вероятными символами.
- Формирование результата. Распознанные элементы объединяются в слова и предложения с учетом их расположения.
- Проверка качества. При наличии соответствующих функций система оценивает результат и помогает обнаружить неоднозначные фрагменты.
Современные решения могут использовать методы машинного обучения, благодаря которым распознавание учитывает различные начертания шрифтов и особенности расположения текста. Тем не менее даже развитые алгоритмы не гарантируют безошибочного результата. Качество фотографии, язык, структура документа и особенности печати по-прежнему имеют значение.
Какие задачи решает распознавание текста с фото онлайн
Главное преимущество онлайн-инструментов состоит в доступности. Для обработки изображения не всегда требуется устанавливать отдельную программу или настраивать сложную рабочую среду. Пользователь может воспользоваться веб-сервисом и получить текст, пригодный для дальнейшего использования.
Практические сценарии зависят от характера исходного материала.
Работа с документами. Фотографии договоров, заявлений, счетов и печатных бланков могут содержать сведения, которые необходимо перенести в электронную систему. Распознавание помогает подготовить основу для редактирования и уменьшить объем ручной работы.
Образование и исследования. Страницы учебников, конспекты, фрагменты научных публикаций и архивные материалы часто требуют цитирования или систематизации. Преобразование изображения в текст упрощает поиск нужных фрагментов и подготовку заметок.
Создание контента. Редакторы, авторы и специалисты по цифровому продвижению могут извлекать текст из фотографий вывесок, печатных каталогов и других материалов. Полученные сведения удобно использовать при подготовке черновиков, описаний и справочных публикаций, соблюдая авторские права.
Деловая переписка. Если необходимые сведения представлены на снимке письма, объявления или инструкции, распознавание помогает перенести их в рабочий документ без повторного набора.
Личные архивы. Старые записи, рецепты, памятки и семейные документы можно перевести в электронный вид, чтобы упростить хранение и поиск.
Во всех перечисленных случаях технология выполняет вспомогательную функцию. Она ускоряет извлечение информации, но не заменяет проверку фактов, оценку содержания и принятие решений человеком.
От чего зависит точность распознавания
Даже качественный сервис не способен полностью компенсировать недостатки исходного изображения. Чем отчетливее символы и чем проще структура документа, тем выше вероятность получить корректный текст.
В первую очередь значение имеют следующие факторы.
- Резкость. Размытые буквы теряют характерные элементы, из-за чего система может путать похожие символы.
- Освещение. Блики, тени и неравномерная яркость ухудшают различимость строк.
- Разрешение. На изображениях с недостаточной детализацией мелкие знаки могут сливаться.
- Положение страницы. Сильный наклон или перспектива искажают форму строк.
- Типографика. Необычные шрифты, рукописные записи и декоративные символы распознаются сложнее обычного печатного текста.
- Структура документа. Многоколоночная верстка, таблицы, сноски и текстовые вставки могут нарушать правильный порядок чтения.
- Язык и символы. Смешение алфавитов, сокращения, специальные знаки и формулы повышают вероятность ошибок.
Особое внимание требуется уделять числовым данным. Буквы и цифры, внешне похожие друг на друга, иногда определяются неверно. Например, в зависимости от шрифта система может спутать латинскую букву O с цифрой 0 или букву I с цифрой 1. В обычном тексте такая ошибка иногда заметна сразу, а в номере договора или банковских реквизитах она способна привести к серьезным последствиям.
Поэтому результат распознавания следует рассматривать как подготовленную цифровую версию исходника, а не как автоматически подтвержденную копию.
Как подготовить фотографию для получения качественного результата
Качество обработки во многом определяется еще до загрузки файла. Несколько простых действий позволяют уменьшить количество ошибок и сократить время на последующую проверку.
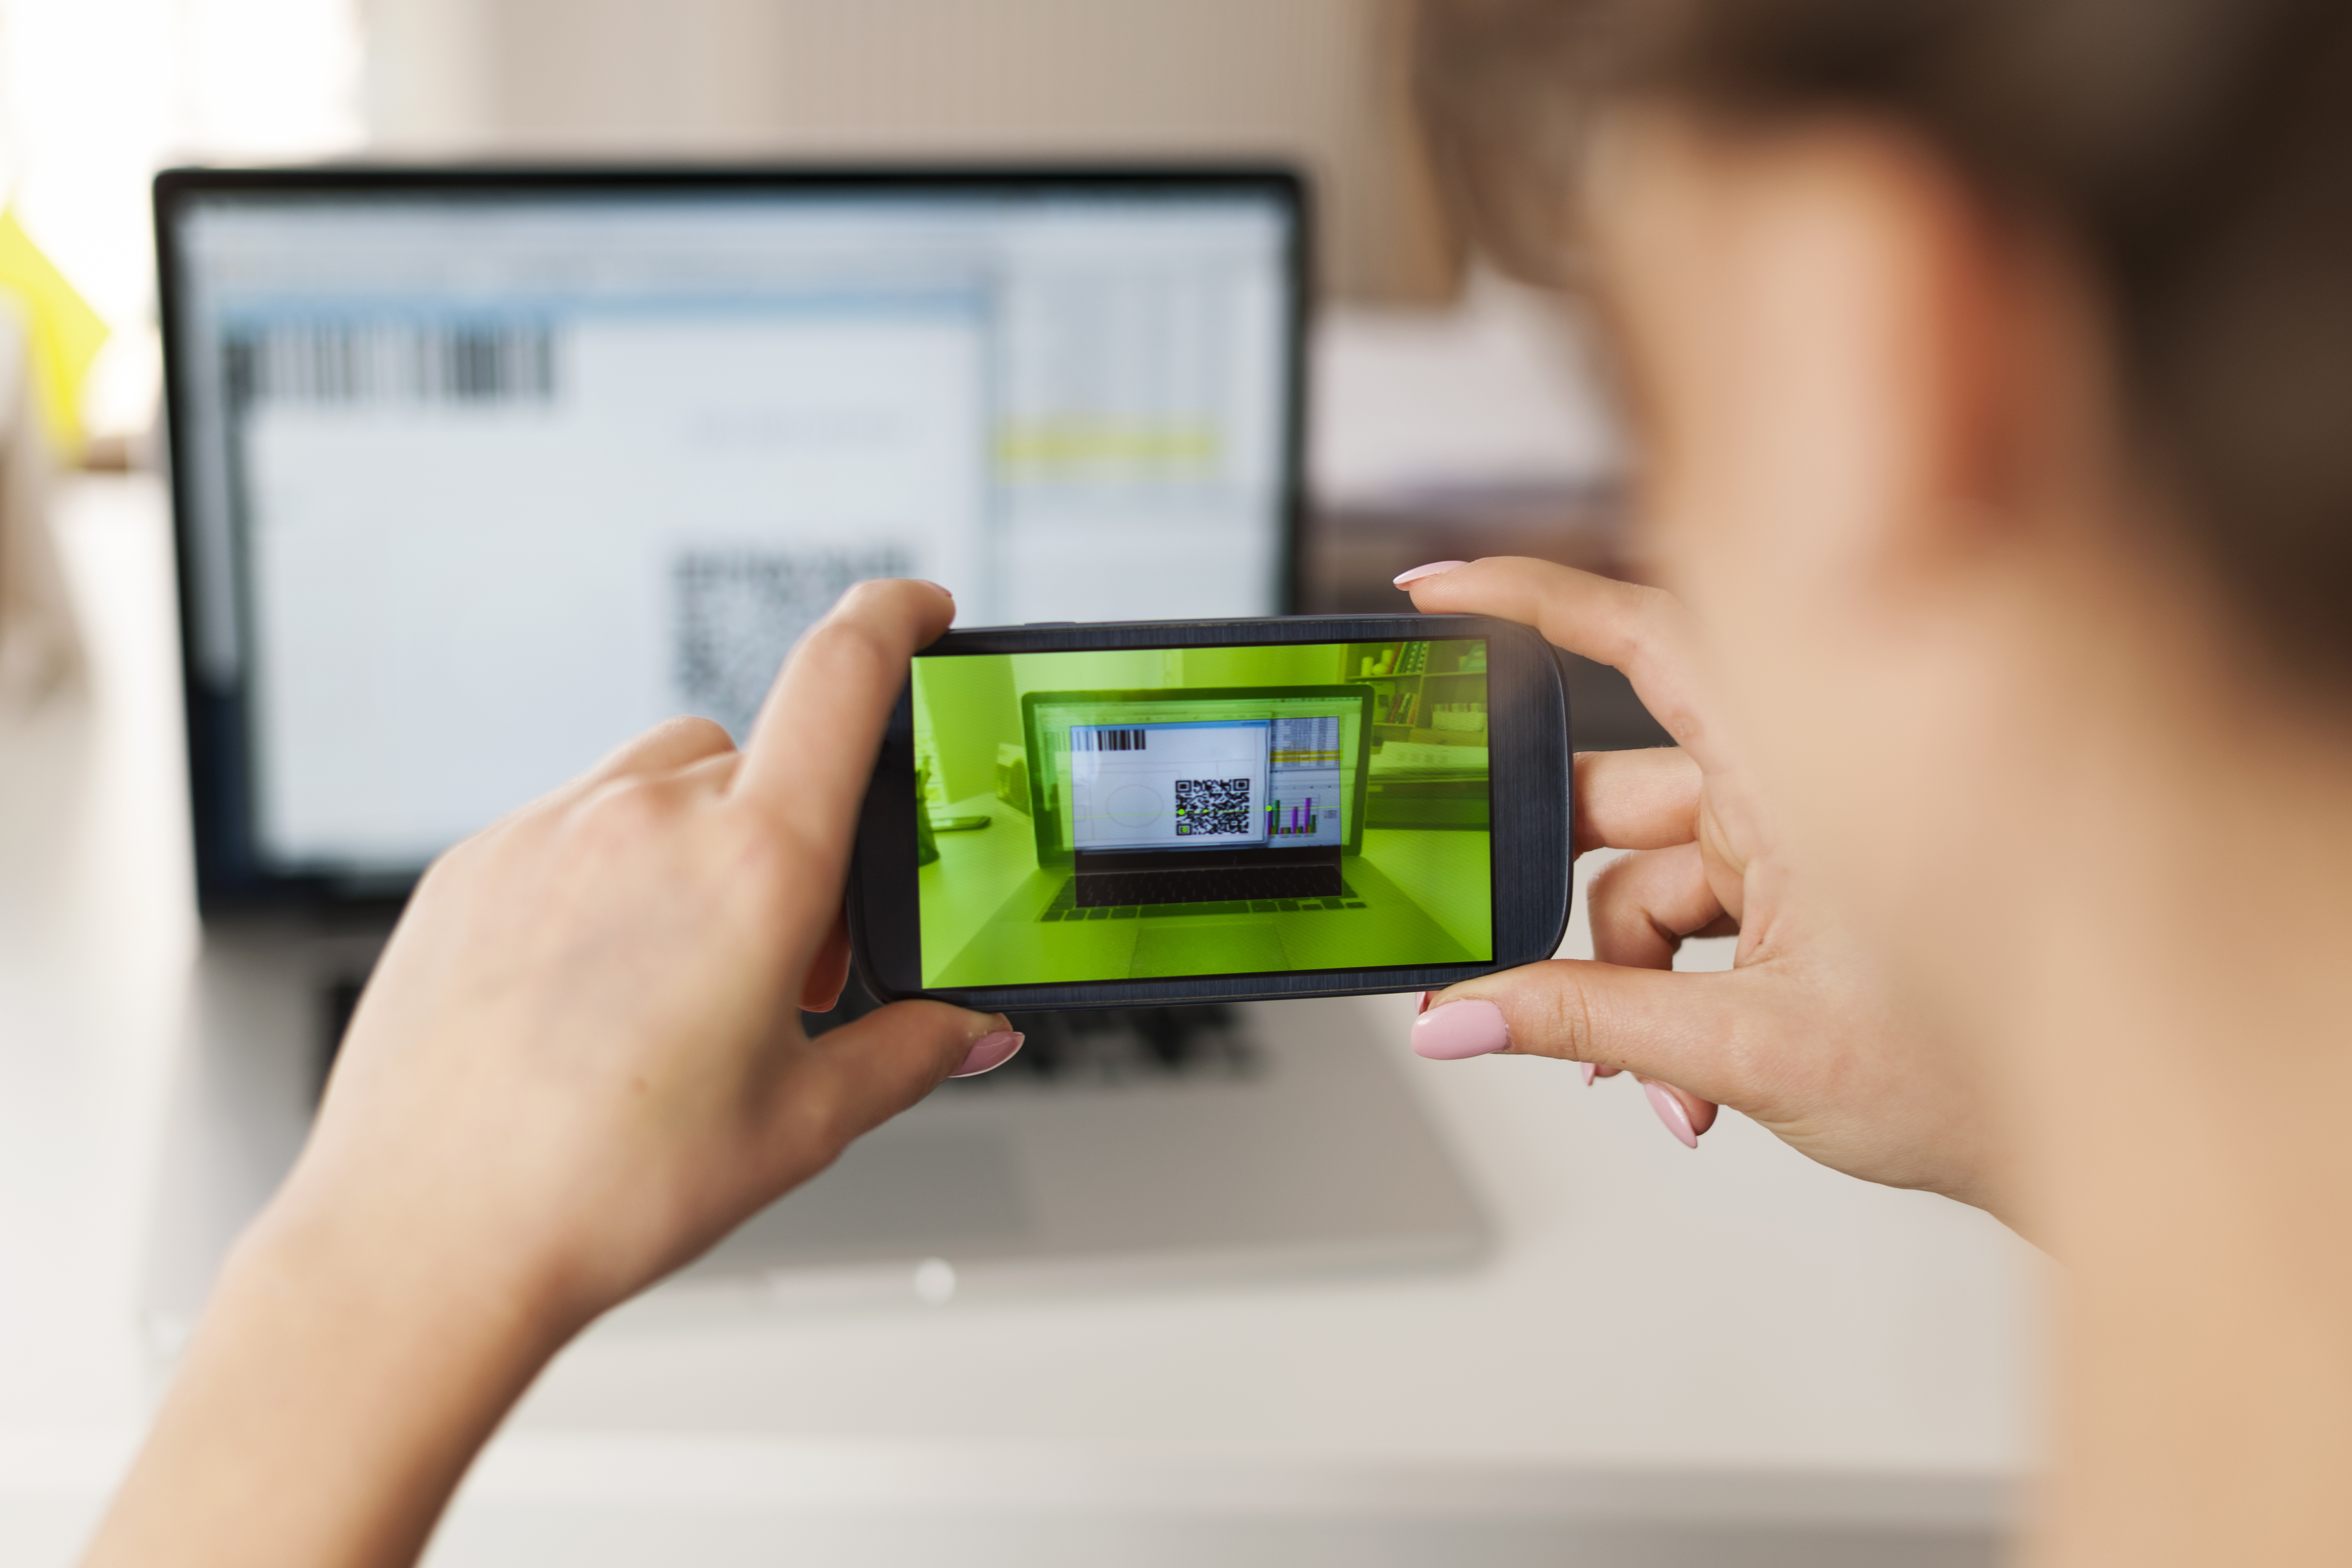
Во время съемки желательно располагать камеру параллельно странице, избегать резких теней и следить, чтобы все края документа попадали в кадр. Текст должен оставаться четким при увеличении изображения.
Если фотография уже сделана, полезно проверить ее перед обработкой. При необходимости изображение можно обрезать, повернуть и скорректировать яркость. При этом чрезмерная обработка нежелательна: потеря деталей способна ухудшить распознавание.
Для получения более точного результата рекомендуется:
- Использовать оригинальную фотографию вместо изображения, многократно пересохраненного через мессенджеры.
- Проверять читаемость мелкого шрифта при увеличении.
- Убирать лишние участки фона, не обрезая буквы и знаки препинания.
- Разделять слишком большие документы на отдельные страницы, если сервис не поддерживает пакетную обработку.
- Проверять правильность языка распознавания, если такая настройка предусмотрена.
- Сохранять исходный файл до завершения проверки результата.
Эти действия не требуют специальных технических знаний. При этом они позволяют избежать многих ошибок, которые иначе пришлось бы исправлять вручную.
Онлайн-сервис и ручной набор текста
Выбор способа обработки зависит от объема информации, требований к точности и сложности исходного материала. Автоматическое распознавание наиболее полезно там, где необходимо извлечь большой объем обычного печатного текста.
Ручной набор сохраняет преимущества при работе с короткими фрагментами, сложными формулами, неразборчивыми рукописными заметками и документами, в которых требуется сразу изменить содержание. Человек способен учитывать смысл и исправлять очевидные неточности по ходу работы, тогда как алгоритм прежде всего анализирует визуальные признаки.
Онлайн-распознавание особенно оправданно, если необходимо:
- Перенести несколько абзацев с фотографии в текстовый редактор.
- Обработать значительное количество страниц.
- Подготовить текстовую основу для поиска и сортировки.
- Сократить объем повторяющихся операций.
- Получить результат без установки специализированного программного обеспечения, если выбранный сервис работает непосредственно в браузере.
При небольшом объеме материала разница во времени может оказаться незначительной. Однако по мере увеличения числа страниц автоматизация становится более заметным преимуществом. При этом общие затраты следует оценивать с учетом проверки результата: чем хуже исходные снимки, тем больше времени потребуется на исправление ошибок.
Как использовать распознанный текст в рабочих процессах
После преобразования изображения в текст появляется возможность встроить информацию в привычные цифровые процессы. Это особенно полезно для специалистов, которые регулярно работают с документами, публикациями и справочными материалами.
Например, распознанный фрагмент можно перенести в текстовый редактор, отредактировать и включить в отчет. Извлеченные из перечня сведения можно подготовить для последующего переноса в электронную таблицу. Текст с фотографии инструкции удобно использовать при создании внутренней базы знаний.
Для редакционных задач OCR помогает получить черновую текстовую основу из печатных материалов. После проверки содержания редактор может структурировать текст, исправить ошибки и привести оформление к требованиям публикации. При этом само распознавание не обеспечивает уникальность нового материала и не дает права на свободное использование чужих произведений.
Для бизнеса технология полезна при оцифровке архивов и подготовке документов к дальнейшей обработке. Однако полноценный электронный архив требует большего, чем обычный текстовый файл. Важны понятные названия документов, единая система хранения, резервные копии и возможность быстро найти нужную запись.
Наиболее эффективный подход заключается в разделении работы на этапы: сначала извлечение текста, затем проверка, после этого классификация и сохранение в подходящем формате. Такой порядок позволяет использовать скорость автоматизации без потери контроля над результатом.
Безопасность при обработке фотографий документов
Удобство онлайн-инструментов не отменяет необходимости внимательно относиться к содержимому загружаемых файлов. Фотография может включать персональные данные, адреса, подписи, номера документов, финансовые сведения или внутреннюю деловую информацию.
Перед загрузкой конфиденциального материала необходимо ознакомиться с правилами обработки данных конкретного сервиса. Важно выяснить, как долго хранятся файлы, используются ли они для других целей и предусмотрена ли возможность удаления. Сам факт работы через браузер не означает, что изображение обрабатывается исключительно на устройстве пользователя.
Если документ содержит сведения ограниченного доступа, предпочтение следует отдавать решениям, соответствующим требованиям организации и применимым правилам защиты данных. В отдельных случаях безопаснее использовать локальное программное обеспечение, не передающее исходные файлы стороннему оператору.
Дополнительную осторожность следует проявлять при работе с документами, которые содержат данные третьих лиц. Необходимость извлечения текста не отменяет обязанностей по защите такой информации.
Частые вопросы о распознавании текста с фотографии
Можно ли распознать текст с фотографии, сделанной на смартфон?
Да, если изображение достаточно четкое и символы хорошо различимы. Для обычного печатного текста снимка смартфона часто достаточно, однако качество результата зависит от разрешения, освещения и положения страницы.
Подходит ли технология для документов на русском языке?
Распознавание русского текста поддерживается многими современными OCR-решениями. При этом качество зависит от возможностей конкретного инструмента, используемого шрифта и состояния изображения.
Сохраняется ли исходное форматирование?
Не всегда. Некоторые инструменты извлекают только текст, другие пытаются сохранить абзацы, заголовки, колонки и таблицы. После обработки сложных документов оформление желательно проверить отдельно.
Можно ли распознать рукописные записи?
Это зависит от возможностей сервиса и разборчивости почерка. Рукописный текст обычно представляет более сложную задачу, чем печатный, поэтому результат требует особенно внимательной проверки.
Нужно ли устанавливать программу для обработки фотографии?
Онлайн-инструменты позволяют выполнять распознавание непосредственно через браузер, если выбранный сервис поддерживает такой способ работы. Дополнительные программы могут понадобиться для расширенных задач или обработки больших архивов.
Что делать, если в результате появились ошибки?
Следует сравнить распознанный текст с исходным изображением. Особое внимание стоит уделить цифрам, именам, датам, сокращениям и знакам препинания. Если ошибок много, полезно подготовить более качественную фотографию и повторить обработку.
Можно ли использовать распознанный текст в коммерческих материалах?
Технически полученный текст можно редактировать и включать в рабочие процессы. Однако допустимость публикации зависит от прав на исходный материал, условий его использования и характера содержащихся сведений. Само преобразование фотографии в текст не отменяет авторских прав.
Цифровая обработка начинается с простого шага
Распознавание текста с фотографии помогает превратить визуальную информацию в материал, пригодный для поиска, редактирования и повторного использования. Особенно заметна польза технологии при работе с большими объемами печатных документов, учебными материалами и деловой документацией.
При этом качественный результат складывается из трех составляющих: подходящего инструмента, хорошего исходного изображения и внимательной проверки. Автоматизация сокращает рутинную работу, но окончательная ответственность за корректность данных остается у пользователя.
Онлайн-сервис Qivrora можно рассматривать как один из вариантов для решения задачи извлечения текста из фотографии. Перед обработкой важных или конфиденциальных документов следует проверить доступные функции, ограничения и условия использования инструмента. Такой подход позволяет получить практическую пользу от технологии, сохранив контроль над качеством и безопасностью информации.